Was eine PLS-Kalibrierung ist und warum jeder Schritt validiert werden muss
Die Partial-Least-Squares-Regression verknüpft eine Spektralmatrix X über eine kleine Zahl latenter Variablen mit Referenzwerten Y, und ihren Platz in der Nahinfrarotkalibrierung verdankt sie ihrer Fähigkeit, viele verrauschte, kollineare und sogar unvollständige Variablen zu verarbeiten [1]. Das Tutorial von Geladi und Kowalski zeigt, wo die gewöhnliche Regression bei solchen Daten versagt, entwickelt PLS als Abhilfe und liefert einen Algorithmus samt praktischen Hinweisen zu seiner Anwendung [2]. Die Methode selbst wird im Begleitartikel Wie NIR-Kalibrierung funktioniert: PLS erklärt erläutert; dieser Leitfaden befasst sich mit den Entscheidungen, die ein Anwender beim Aufbau einer Kalibrierung trifft. Jede davon — wie die Proben aufgeteilt werden, welche Vorbehandlung angewendet wird, wie viele latente Variablen behalten werden, welche Proben entfernt werden — verändert die Gütekennzahlen, und Westad und Marini zeigen, dass die Ebene, auf der ein Modell validiert wird, sowohl seinen angegebenen Fehler als auch seine gewählte Dimensionalität beeinflusst [3].
Aufteilen der Daten
Snees Übersicht zur Regressionsvalidierung kommt zu dem Schluss, dass die Datenaufteilung, bei der ein Teil der Daten das Modell schätzt und der Rest seine Vorhersagegenauigkeit misst, ein wirksamer Weg zur Validierung eines Modells ist, wenn das Sammeln neuer Daten nicht praktikabel ist, und empfiehlt Kennards DUPLEX-Algorithmus für die Aufteilung, wenn es keine offensichtliche Variable wie die Zeit gibt, auf die sie sich stützen kann [4]. Das verwandte Kennard–Stone-Verfahren wählt Punkte sequenziell so aus, dass jeder Schritt den Versuchsraum gleichmäßig abdeckt [5], weshalb es häufig verwendet wird, um Kalibrierproben auszuwählen, die den Spektralraum aufspannen. Eine rein zufällige Aufteilung ist nicht automatisch stichhaltig: Westad und Marini warnen, dass die wiederholte zufällige Aufteilung eines Datensatzes in Kalibrier- und Testsätze nur dann zu rechtfertigen ist, wenn keine systematische Schichtung der Proben vorliegt, und sie unterscheiden Validierungsebenen — Wiederholbarkeit, Reproduzierbarkeit, Geräte- und Rohstoffvariation —, die eine Aufteilung respektieren sollte, wenn die Fehlerschätzung etwas über künftige Proben aussagen soll [3].
Auch die Größe des zurückgehaltenen Satzes ist eine Entscheidung und keine Konvention. In einer Monte-Carlo-Studie an NIR-Spektren ganzer Maispflanzen zogen Martens und Dardenne kleine Kalibriersätze von 40 bis 120 Proben aus einer Datenbank von 922 und stellten fest, dass das Zurückhalten eines unabhängigen Testsatzes aus einem ohnehin kleinen Bestand die Vorhersageleistung verringerte, während die vollständige Kreuzvalidierung bessere Vorhersagen lieferte und nur geringfügig zu optimistisch war [6]. Praktisch bedeutet das: Ein separater Testsatz ist am wertvollsten, wenn Proben reichlich vorhanden sind oder wenn er eine tatsächlich spätere oder andere Population repräsentiert; bei wenigen Proben nutzt die Kreuzvalidierung sie besser [3][6].
Wahl der Vorbehandlung
Rinnan et al. gliedern die gängigen NIR-Vorbehandlungsmethoden in Streukorrekturen (MSC, SNV, Normierung) und spektrale Ableitungen und vergleichen ihre Wirkung an realen Daten [7]; die Mechanik wird im MSC/SNV-Leitfaden und im Savitzky-Golay-Leitfaden behandelt. Für den Kalibrierablauf ist der Punkt verfahrenstechnischer Natur: Vorbehandlungseinstellungen sind Hyperparameter des Modells, daher sollten Kandidaten-Pipelines mit demselben Validierungsdesign verglichen werden wie die Anzahl latenter Variablen, niemals anhand der Kalibrieranpassung. Wiklund et al. merken an, dass ihr Test zur Komponentenauswahl zugleich anzeigt, ob die Daten eine Vorbehandlung erfordern; das ist eine nützliche Gegenprobe, wenn ein Modell auf Rohspektren deutlich mehr Komponenten benötigt als ein Ableitungsmodell [8].
Wie viele latente Variablen
Die Anzahl latenter Variablen ist die wichtigste einzelne Einstellung bei PLS: Zu wenige lassen chemische Information unmodelliert, zu viele passen Rauschen an, das in neuen Proben nicht wiederkehrt [1][2]. Das Standardwerkzeug ist die Kreuzvalidierung, deren allgemeine Form Stone für die Wahl und Beurteilung von Prädiktoren einführte [9]; bei PLS wird das Modell unter Auslassung von Teilen der Daten neu angepasst, und der kreuzvalidierte Fehler wird gegen die Anzahl der Komponenten aufgetragen [1]. Die übliche Regel ist, am Minimum dieser Kurve oder knapp davor aufzuhören, doch die Wahl der Segmente ist entscheidend. Shao zeigte, dass die Leave-One-Out-Kreuzvalidierung zur Auswahl des Modells mit der besten Vorhersagefähigkeit asymptotisch inkonsistent ist und dass sich die Inkonsistenz durch das Auslassen größerer Beobachtungsblöcke beheben lässt [10]; in der Praxis spricht das für eine segmentierte oder gruppierte Kreuzvalidierung, bei der Wiederholmessungen und Proben derselben Charge im selben Segment bleiben, statt für das Auslassen einzelner Spektren. Wiklund et al. bieten einen ergänzenden Randomisierungstest, der ohne Ausschluss von Daten auskommt und an simulierten Daten bekannter Dimensionalität sowie zehn realen Datensätzen in Kombination mit anderen Auswahlregeln gut funktionierte [8].
Lesen der Diagnosen
In jedem Modellbericht erscheinen drei Fehlerkennzahlen. Der Kalibrierfehler (RMSEC) beschreibt die Anpassung und ist stets der kleinste; der Kreuzvalidierungsfehler (RMSECV) schätzt die Vorhersage innerhalb der Kalibrierpopulation; der Vorhersagefehler an einem unabhängigen Satz (RMSEP) ist der einzige, der Proben prüft, die das Modell nie gesehen hat, und die Validierungsebene dieses Satzes bestimmt, was er bedeutet [3]. ISO 12099 legt die Statistik zur Leistungsmessung dar, einschließlich des Standardfehlers der Vorhersage und des Bias, und gibt in ihrem informativen Anhang Beispiele für Ausreißer und Regelkarten [11]. Eine große Lücke zwischen RMSECV und RMSEP oder ein Bias am Testsatz bedeutet meist, dass sich die Testproben systematisch von der Kalibrierpopulation unterscheiden, und nicht, dass das Modell an sich falsch ist [3].
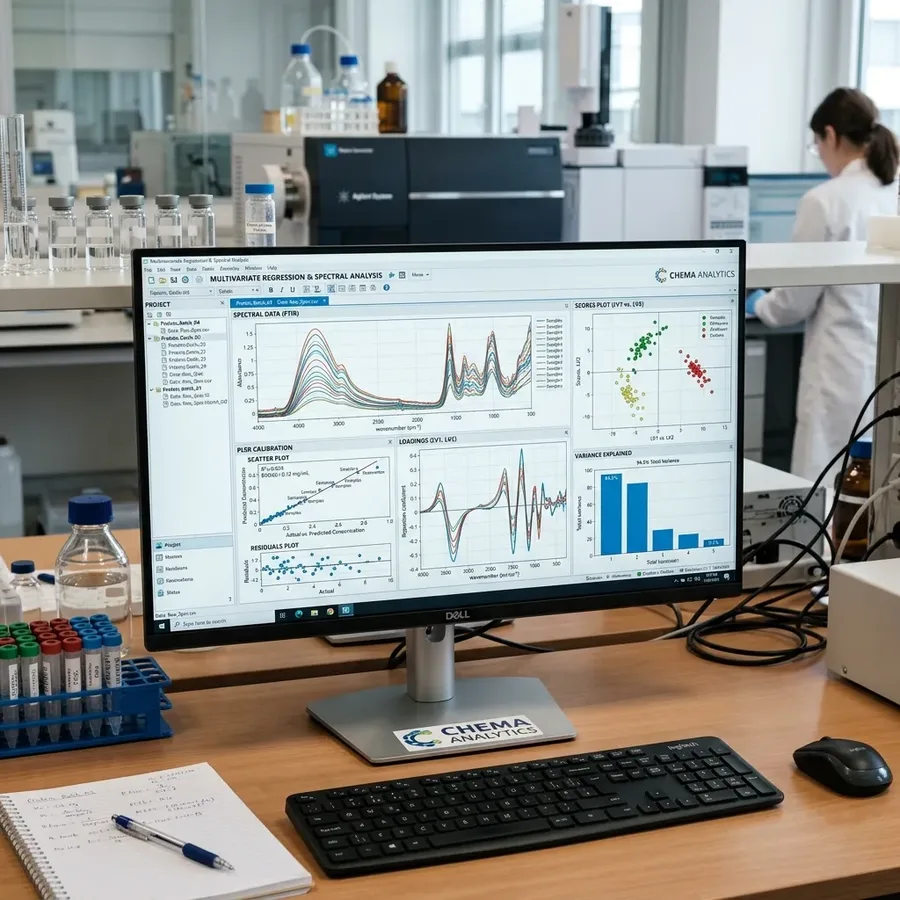
Probendiagnosen vervollständigen das Bild. Wold et al. beschreiben die üblichen PLS-Diagnosen — Scores, Loadings, Residuen und Abstand zum Modell —, mit denen Proben gefunden werden, die im Spektralraum weit von den übrigen entfernt liegen oder schlecht angepasst sind [1]. Hubert und Vanden Branden zeigen, dass die Ergebnisse des verbreiteten SIMPLS-Algorithmus, da er auf der empirischen Kreuzkovarianzmatrix und gewöhnlichen kleinsten Quadraten beruht, durch abweichende Beobachtungen beeinflusst werden; sie führen robuste Varianten mit robusten RMSECV- und RMSEP-Werten sowie Diagnosegrafiken ein, die die Ausreißer sichtbar machen und klassifizieren [12]. Unabhängig vom Werkzeug sollte eine Probe nur mit dokumentiertem Grund aus der Kalibrierung entfernt werden: ein falscher Referenzwert, ein Spektrum eines anderen Materials oder ein Messfehler. Drei Gewohnheiten halten die Diagnosen ehrlich:
- Zuerst das Validierungsdesign festlegen. Legen Sie Aufteilung und Kreuzvalidierungssegmente vor jedem Durchlauf über Vorbehandlungen oder Komponenten fest und verwenden Sie für jeden Kandidaten dasselbe Design, damit der Vergleich fair ist [3].
- RMSECV und RMSEP zusammen mit ihrer Validierungsebene angeben. Ein an Wiederholspektren derselben Proben geschätzter Fehler ist nicht mit einem an einer späteren Produktionscharge geschätzten vergleichbar [3].
- Das Entfernen von Ausreißern als Modellentscheidung behandeln. Halten Sie fest, welche Proben entfernt wurden und warum; eine Markierung durch Residuum oder Hebelwert ist ein Anlass zur Untersuchung, keine Erlaubnis zum Löschen [1][12].
Das Modell am Leben halten
Eine Kalibrierung ist für die Population und den Gerätezustand validiert, auf denen sie aufgebaut wurde. ASTM E1655 legt Verfahren zum Erfassen und Behandeln von Daten für Infrarotkalibrierungen dar, beschreibt Kalibriertechniken und Kriterien zur Validierung der Modellleistung, setzt voraus, dass der Analysator zu den Zeitpunkten von Kalibrierung und Validierung unter den vom Hersteller spezifizierten Bedingungen arbeitet, und stellt einen Fragenkatalog bereit, anhand dessen eine multivariate Kalibrierung geprüft werden kann [13]. ISO 12099 ergänzt die betriebliche Seite: Prüfung der Gerätestabilität und laufende Leistungskontrolle der Kalibrierung mit Regelkarten als Überwachungswerkzeug [11]. Westad und Marini betonen, dass die Robustheit eines Modells für die Vorhersage künftiger Proben wichtiger ist als jede einzelne Gütekennzahl [3]; in der Praxis bedeutet das eine Routine von Referenzprüfungen an Produktionsproben, Regelkarten für Bias und Vorhersagefehler und eine geplante Erweiterung des Kalibriersatzes, wenn neue Rohstoffe, Jahreszeiten oder Prozessbedingungen auftreten.
Der Arbeitsablauf in caliX
Die caliX-Suite bildet die obigen Schritte als Arbeitsablauf aus acht Modulen für NIR-, FTIR- und Raman-Spektren ab. Das Datenmodul importiert Spektren und Referenzwerte aus Excel- oder CSV-Dateien und unterstützt die Datenbereinigung mit PCA- und PLS-Hebelwertkennzahlen; der Vorbehandlungsschritt bietet SNV, MSC, Trendbereinigung, Autoskalierung und Savitzky-Golay-Ableitungen [7]; die manuellen und automatischen Regressionsmodule erstellen PLS-, robuste PLS-, PCR- und regularisierte Modelle, wobei die maximale Anzahl latenter Variablen und die Anzahl der Kreuzvalidierungsfalten vom Anwender festgelegt werden und der automatische Modus Pipeline-Kombinationen durchläuft und den Knickpunkt der Validierungskurve markiert [1][10]. Die Ausreißerdiagnosen umfassen Hotelling-T² und Q-Residuen, PLS-Hebelwert und Mahalanobis-Abstand [12], ein Vorhersagemodul wendet das fertige Modell auf unbekannte Proben an, und die Module Data Transfer und Model Converter übernehmen die Gerätestandardisierung und den Export des Modells für den Einsatz über ProChem. Welche Aufteilung, Vorbehandlung und Komponentenzahl für ein bestimmtes Produkt richtig sind, wird in einer Machbarkeitsstudie mit Ihren eigenen Proben und Referenzanalysen ermittelt.
Quellen
- [1] Wold, S., Sjöström, M., Eriksson, L. (2001). PLS-regression: a basic tool of chemometrics. Chemometrics and Intelligent Laboratory Systems, 58(2), 109–130. doi:10.1016/S0169-7439(01)00155-1
- [2] Geladi, P., Kowalski, B.R. (1986). Partial least-squares regression: a tutorial. Analytica Chimica Acta, 185, 1–17. doi:10.1016/0003-2670(86)80028-9
- [3] Westad, F., Marini, F. (2015). Validation of chemometric models – A tutorial. Analytica Chimica Acta, 893, 14–24. doi:10.1016/j.aca.2015.06.056
- [4] Snee, R.D. (1977). Validation of Regression Models: Methods and Examples. Technometrics, 19(4), 415–428. doi:10.1080/00401706.1977.10489581
- [5] Kennard, R.W., Stone, L.A. (1969). Computer Aided Design of Experiments. Technometrics, 11(1), 137–148. doi:10.1080/00401706.1969.10490666
- [6] Martens, H.A., Dardenne, P. (1998). Validation and verification of regression in small data sets. Chemometrics and Intelligent Laboratory Systems, 44(1–2), 99–121. doi:10.1016/S0169-7439(98)00167-1
- [7] Rinnan, Å., van den Berg, F., Engelsen, S.B. (2009). Review of the most common pre-processing techniques for near-infrared spectra. TrAC Trends in Analytical Chemistry, 28(10), 1201–1222. doi:10.1016/j.trac.2009.07.007
- [8] Wiklund, S., Nilsson, D., Eriksson, L., Sjöström, M., Wold, S., Faber, K. (2007). A randomization test for PLS component selection. Journal of Chemometrics, 21(10–11), 427–439. doi:10.1002/cem.1086
- [9] Stone, M. (1974). Cross-Validatory Choice and Assessment of Statistical Predictions. Journal of the Royal Statistical Society: Series B (Methodological), 36(2), 111–133. doi:10.1111/j.2517-6161.1974.tb00994.x
- [10] Shao, J. (1993). Linear Model Selection by Cross-Validation. Journal of the American Statistical Association, 88(422), 486–494. doi:10.1080/01621459.1993.10476299
- [11] ISO 12099:2017. Animal feeding stuffs, cereals and milled cereal products — Guidelines for the application of near infrared spectrometry. ISO, Geneva. iso.org/standard/67352.html
- [12] Hubert, M., Vanden Branden, K. (2003). Robust methods for partial least squares regression. Journal of Chemometrics, 17(10), 537–549. doi:10.1002/cem.822
- [13] ASTM E1655-17(2024). Standard Practices for Infrared Multivariate Quantitative Analysis. ASTM International, West Conshohocken, PA. astm.org/e1655-17r24.html