Qué es una calibración PLS y por qué cada paso necesita validación
La regresión por mínimos cuadrados parciales relaciona una matriz espectral X con valores de referencia Y a través de un pequeño número de variables latentes, y debe su lugar en la calibración de infrarrojo cercano a su capacidad para manejar muchas variables ruidosas, colineales e incluso incompletas [1]. El tutorial de Geladi y Kowalski expone dónde falla la regresión ordinaria con estos datos, desarrolla el PLS como remedio y ofrece un algoritmo junto con consejos prácticos para su uso [2]. El método en sí se explica en el artículo complementario Cómo funciona la calibración NIR: el PLS explicado; esta guía trata de las decisiones que toma un profesional al construir una. Cada una de ellas — cómo se dividen las muestras, qué pretratamiento se aplica, cuántas variables latentes se conservan, qué muestras se eliminan — modifica las cifras de mérito, y Westad y Marini muestran que el nivel en el que se valida un modelo afecta tanto a su error declarado como a la dimensionalidad elegida [3].
División de los datos
La revisión de Snee sobre la validación de regresiones concluye que la división de datos, en la que una parte de los datos estima el modelo y el resto mide su exactitud predictiva, es una forma eficaz de validar un modelo cuando no es práctico recoger datos nuevos, y recomienda el algoritmo DUPLEX de Kennard para realizar la división cuando no existe una variable evidente, como el tiempo, en la que basarla [4]. El procedimiento relacionado de Kennard–Stone selecciona puntos de forma secuencial de modo que cada paso cubra uniformemente la región experimental [5], por lo que se usa mucho para elegir muestras de calibración que abarquen el espacio espectral. Una división puramente aleatoria no es automáticamente válida: Westad y Marini advierten que dividir repetidamente al azar un conjunto de datos en conjuntos de calibración y prueba solo puede justificarse cuando no hay una estratificación sistemática de las muestras, y distinguen niveles de validación — repetibilidad, reproducibilidad, variación del instrumento y de la materia prima — que una división debe respetar si la estimación del error ha de decir algo sobre las muestras futuras [3].
El tamaño del conjunto reservado es también una decisión, no una convención. En un estudio de Monte Carlo con espectros NIR de plantas enteras de maíz, Martens y Dardenne extrajeron pequeños conjuntos de calibración de 40 a 120 muestras de una base de datos de 922 y comprobaron que reservar un conjunto de prueba independiente de un grupo ya pequeño reducía el rendimiento predictivo, mientras que la validación cruzada completa daba mejores predicciones y solo era ligeramente optimista [6]. La lectura práctica es que un conjunto de prueba separado es más valioso cuando las muestras abundan o cuando representa una población realmente posterior o distinta; con pocas muestras, la validación cruzada las aprovecha mejor [3][6].
Elección del pretratamiento
Rinnan et al. agrupan los métodos habituales de pretratamiento NIR en correcciones de dispersión (MSC, SNV, normalización) y derivadas espectrales, y comparan sus efectos sobre datos reales [7]; la mecánica se trata en la guía de MSC/SNV y en la guía de Savitzky-Golay. Para el flujo de calibración, la cuestión es de procedimiento: los ajustes de pretratamiento son hiperparámetros del modelo, de modo que las cadenas candidatas deben compararse con el mismo diseño de validación que el número de variables latentes, nunca con el ajuste de calibración. Wiklund et al. señalan que su prueba de selección de componentes actúa también como indicador de que los datos requieren un pretratamiento, lo cual es una comprobación cruzada útil cuando un modelo con espectros sin tratar necesita muchos más componentes que un modelo con derivadas [8].
Cuántas variables latentes
El número de variables latentes es el ajuste individual más importante en PLS: demasiado pocas dejan información química sin modelar, demasiadas ajustan ruido que no se repetirá en muestras nuevas [1][2]. La herramienta estándar es la validación cruzada, cuya forma general introdujo Stone para la elección y evaluación de predictores [9]; en PLS el modelo se reajusta dejando fuera partes de los datos, y el error de validación cruzada se representa frente al número de componentes [1]. La regla convencional es detenerse en el mínimo de esa curva o justo antes, pero la elección de los segmentos importa. Shao demostró que la validación cruzada dejando uno fuera es asintóticamente inconsistente para seleccionar el modelo con mejor capacidad predictiva, y que la inconsistencia se corrige dejando fuera bloques mayores de observaciones [10]; en la práctica esto favorece la validación cruzada segmentada o por grupos, con las mediciones replicadas y las muestras del mismo lote en el mismo segmento, frente a dejar fuera espectros individuales. Wiklund et al. ofrecen una prueba de aleatorización complementaria que no requiere excluir datos y que, con datos simulados de dimensionalidad conocida y diez conjuntos de datos reales, funcionó bien combinada con otras reglas de selección [8].
Lectura de los diagnósticos
En todo informe de modelo aparecen tres cifras de error. El error de calibración (RMSEC) describe el ajuste y es siempre el menor; el error de validación cruzada (RMSECV) estima la predicción dentro de la población de calibración; el error de predicción en un conjunto independiente (RMSEP) es el único que pone a prueba muestras que el modelo nunca ha visto, y el nivel de validación de ese conjunto determina lo que significa [3]. La ISO 12099 expone la estadística para medir el rendimiento, incluidos el error estándar de predicción y el sesgo, y ofrece ejemplos de valores atípicos y gráficos de control en su anexo informativo [11]. Una gran diferencia entre el RMSECV y el RMSEP, o un sesgo en el conjunto de prueba, suele significar que las muestras de prueba difieren sistemáticamente de la población de calibración, más que que el modelo esté mal en sí mismo [3].
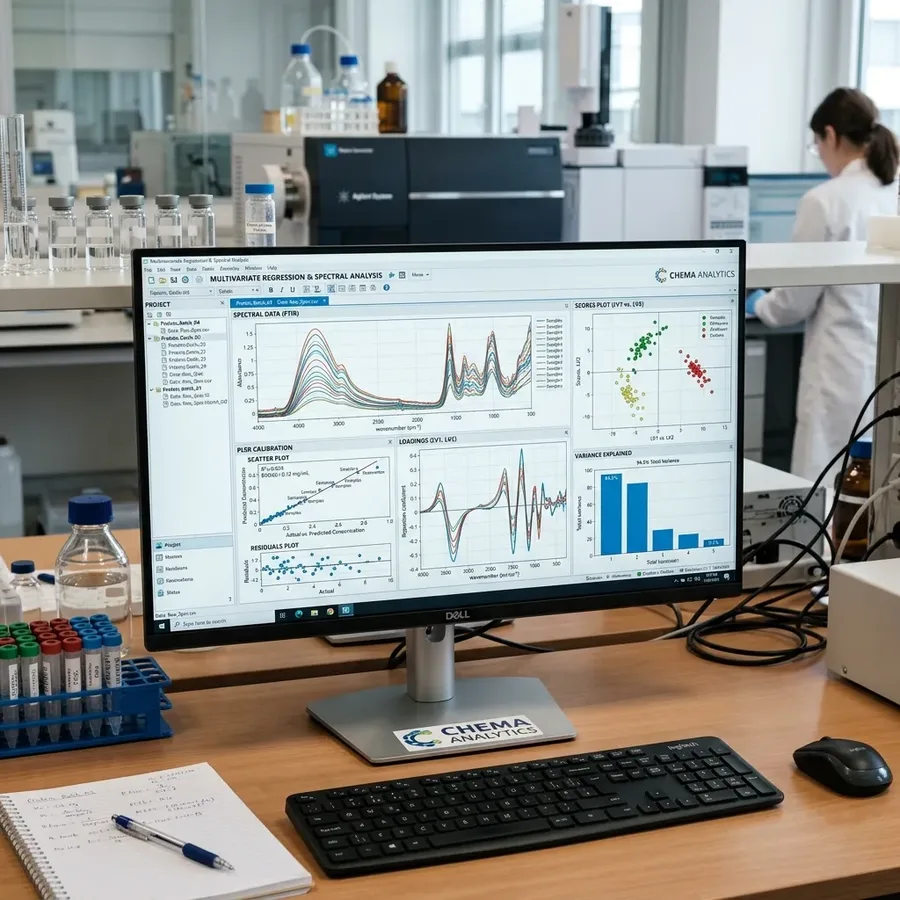
Los diagnósticos de muestras completan el cuadro. Wold et al. revisan los diagnósticos PLS habituales — puntuaciones, cargas, residuos y distancia al modelo — que se emplean para encontrar muestras alejadas de las demás en el espacio espectral o mal ajustadas [1]. Hubert y Vanden Branden muestran que, como el algoritmo SIMPLS habitual se basa en la matriz empírica de covarianza cruzada y en mínimos cuadrados ordinarios, sus resultados se ven afectados por observaciones anómalas; introducen variantes robustas con valores robustos de RMSECV y RMSEP, y gráficos de diagnóstico que visualizan y clasifican los valores atípicos [12]. Sea cual sea la herramienta, una muestra solo debe eliminarse de la calibración con un motivo documentado: un valor de referencia erróneo, un espectro de otro material o un fallo de medición. Tres hábitos mantienen honestos los diagnósticos:
- Decidir primero el diseño de validación. Fije la división y los segmentos de validación cruzada antes de cualquier barrido de pretratamientos o de componentes, y utilice el mismo diseño para cada candidato para que la comparación sea justa [3].
- Informar del RMSECV y el RMSEP junto con su nivel de validación. Un error estimado con espectros replicados de las mismas muestras no es comparable con uno estimado en un lote de producción posterior [3].
- Tratar la eliminación de atípicos como una decisión del modelo. Registre qué muestras se eliminaron y por qué; una alerta por residuo o apalancamiento es una invitación a investigar, no una licencia para borrar [1][12].
Mantener vivo el modelo
Una calibración está validada para la población y el estado del instrumento con los que se construyó. La ASTM E1655 establece prácticas para recoger y tratar datos para calibraciones de infrarrojo, describe técnicas de calibración y criterios para validar el rendimiento del modelo, presupone que el analizador funciona en las condiciones especificadas por el fabricante en los momentos de la calibración y la validación, y proporciona un cuestionario con el que puede examinarse una calibración multivariante [13]. La ISO 12099 añade la parte operativa: la comprobación de la estabilidad del instrumento y un control continuo del rendimiento de la calibración, con gráficos de control como herramienta de seguimiento [11]. Westad y Marini subrayan que la robustez de un modelo para predecir muestras futuras importa más que cualquier cifra de mérito aislada [3]; en la práctica, esto significa una rutina de comprobaciones de referencia sobre muestras de producción, gráficos de control del sesgo y del error de predicción, y una actualización planificada del conjunto de calibración cuando aparecen nuevas materias primas, estaciones o condiciones de proceso.
El flujo de trabajo en caliX
El paquete caliX organiza los pasos anteriores como un flujo de trabajo de ocho módulos para espectros NIR, FTIR y Raman. El módulo de datos importa espectros y valores de referencia desde archivos Excel o CSV y permite la limpieza de datos con métricas de apalancamiento PCA y PLS; la etapa de pretratamiento ofrece SNV, MSC, eliminación de tendencia, autoescalado y derivadas de Savitzky-Golay [7]; los módulos de regresión manual y automática construyen modelos PLS, PLS robusto, PCR y regularizados, con el número máximo de variables latentes y el número de particiones de validación cruzada fijados por el usuario, y el modo automático recorre combinaciones de cadenas de procesamiento y marca el punto de codo de la curva de validación [1][10]. Los diagnósticos de valores atípicos incluyen la T² de Hotelling y los residuos Q, el apalancamiento PLS y la distancia de Mahalanobis [12], un módulo de predicción aplica el modelo terminado a muestras desconocidas, y los módulos Data Transfer y Model Converter se encargan de la estandarización entre instrumentos y de la exportación del modelo para su despliegue a través de ProChem. Qué división, pretratamiento y número de componentes son los adecuados para un producto concreto se establece en un estudio de viabilidad con sus propias muestras y análisis de referencia.
Referencias
- [1] Wold, S., Sjöström, M., Eriksson, L. (2001). PLS-regression: a basic tool of chemometrics. Chemometrics and Intelligent Laboratory Systems, 58(2), 109–130. doi:10.1016/S0169-7439(01)00155-1
- [2] Geladi, P., Kowalski, B.R. (1986). Partial least-squares regression: a tutorial. Analytica Chimica Acta, 185, 1–17. doi:10.1016/0003-2670(86)80028-9
- [3] Westad, F., Marini, F. (2015). Validation of chemometric models – A tutorial. Analytica Chimica Acta, 893, 14–24. doi:10.1016/j.aca.2015.06.056
- [4] Snee, R.D. (1977). Validation of Regression Models: Methods and Examples. Technometrics, 19(4), 415–428. doi:10.1080/00401706.1977.10489581
- [5] Kennard, R.W., Stone, L.A. (1969). Computer Aided Design of Experiments. Technometrics, 11(1), 137–148. doi:10.1080/00401706.1969.10490666
- [6] Martens, H.A., Dardenne, P. (1998). Validation and verification of regression in small data sets. Chemometrics and Intelligent Laboratory Systems, 44(1–2), 99–121. doi:10.1016/S0169-7439(98)00167-1
- [7] Rinnan, Å., van den Berg, F., Engelsen, S.B. (2009). Review of the most common pre-processing techniques for near-infrared spectra. TrAC Trends in Analytical Chemistry, 28(10), 1201–1222. doi:10.1016/j.trac.2009.07.007
- [8] Wiklund, S., Nilsson, D., Eriksson, L., Sjöström, M., Wold, S., Faber, K. (2007). A randomization test for PLS component selection. Journal of Chemometrics, 21(10–11), 427–439. doi:10.1002/cem.1086
- [9] Stone, M. (1974). Cross-Validatory Choice and Assessment of Statistical Predictions. Journal of the Royal Statistical Society: Series B (Methodological), 36(2), 111–133. doi:10.1111/j.2517-6161.1974.tb00994.x
- [10] Shao, J. (1993). Linear Model Selection by Cross-Validation. Journal of the American Statistical Association, 88(422), 486–494. doi:10.1080/01621459.1993.10476299
- [11] ISO 12099:2017. Animal feeding stuffs, cereals and milled cereal products — Guidelines for the application of near infrared spectrometry. ISO, Geneva. iso.org/standard/67352.html
- [12] Hubert, M., Vanden Branden, K. (2003). Robust methods for partial least squares regression. Journal of Chemometrics, 17(10), 537–549. doi:10.1002/cem.822
- [13] ASTM E1655-17(2024). Standard Practices for Infrared Multivariate Quantitative Analysis. ASTM International, West Conshohocken, PA. astm.org/e1655-17r24.html