Ce qu'est un étalonnage PLS, et pourquoi chaque étape doit être validée
La régression des moindres carrés partiels relie une matrice spectrale X à des valeurs de référence Y par l'intermédiaire d'un petit nombre de variables latentes, et elle doit sa place dans l'étalonnage proche infrarouge à sa capacité à traiter de nombreuses variables bruitées, colinéaires, voire incomplètes [1]. Le tutoriel de Geladi et Kowalski montre où la régression ordinaire échoue sur de telles données, développe la PLS comme remède et fournit un algorithme accompagné de conseils pratiques pour son utilisation [2]. La méthode elle-même est expliquée dans l'article complémentaire Comment fonctionne l'étalonnage NIR : PLS expliqué ; ce guide porte sur les décisions que prend un praticien lorsqu'il en construit un. Chacune d'elles — la manière de partager les échantillons, le prétraitement appliqué, le nombre de variables latentes retenues, les échantillons écartés — modifie les indicateurs de performance, et Westad et Marini montrent que le niveau auquel un modèle est validé influe à la fois sur l'erreur rapportée et sur la dimension retenue [3].
Partager les données
La revue de Snee sur la validation des régressions conclut que le partage des données, où une partie des données sert à estimer le modèle et le reste à mesurer son exactitude de prédiction, est un moyen efficace de valider un modèle lorsqu'il n'est pas pratique de recueillir de nouvelles données, et recommande l'algorithme DUPLEX de Kennard pour effectuer ce partage lorsqu'aucune variable évidente, comme le temps, ne permet de le fonder [4]. La procédure apparentée de Kennard–Stone sélectionne les points de manière séquentielle de sorte que chaque étape couvre uniformément le domaine expérimental [5], ce qui explique son large emploi pour choisir des échantillons d'étalonnage couvrant l'espace spectral. Un partage purement aléatoire n'est pas automatiquement valable : Westad et Marini avertissent que diviser à répétition un jeu de données au hasard en ensembles d'étalonnage et de test ne se justifie qu'en l'absence de stratification systématique des échantillons, et distinguent des niveaux de validation — répétabilité, reproductibilité, variation de l'instrument et des matières premières — qu'un partage doit respecter si l'estimation de l'erreur doit dire quelque chose des échantillons futurs [3].
La taille de l'ensemble mis de côté est elle aussi une décision, et non une convention. Dans une étude de Monte-Carlo sur des spectres NIR de plantes entières de maïs, Martens et Dardenne ont tiré de petits ensembles d'étalonnage de 40 à 120 échantillons d'une base de 922 et constaté que réserver un ensemble de test indépendant à partir d'un vivier déjà restreint réduisait les performances prédictives, alors qu'une validation croisée complète donnait de meilleures prédictions et n'était que légèrement optimiste [6]. En pratique, un ensemble de test distinct est surtout précieux lorsque les échantillons abondent ou lorsqu'il représente une population réellement ultérieure ou différente ; avec peu d'échantillons, la validation croisée en fait un meilleur usage [3][6].
Choisir le prétraitement
Rinnan et al. regroupent les méthodes de prétraitement NIR courantes en corrections de diffusion (MSC, SNV, normalisation) et dérivées spectrales, et comparent leurs effets sur des données réelles [7] ; les mécanismes sont détaillés dans le guide MSC/SNV et le guide Savitzky-Golay. Pour le déroulement de l'étalonnage, l'enjeu est procédural : les réglages de prétraitement sont des hyperparamètres du modèle, de sorte que les chaînes de traitement candidates doivent être comparées selon le même plan de validation que le nombre de variables latentes, jamais sur l'ajustement d'étalonnage. Wiklund et al. notent que leur test de sélection des composantes sert aussi d'indicateur qu'un prétraitement des données est nécessaire, ce qui constitue une vérification croisée utile lorsqu'un modèle sur spectres bruts exige beaucoup plus de composantes qu'un modèle sur dérivées [8].
Combien de variables latentes
Le nombre de variables latentes est le réglage le plus important de la PLS : trop peu laissent de l'information chimique non modélisée, trop ajustent un bruit qui ne se reproduira pas dans de nouveaux échantillons [1][2]. L'outil standard est la validation croisée, dont Stone a introduit la forme générale pour le choix et l'évaluation des prédicteurs [9] ; en PLS, le modèle est réajusté en laissant de côté des parties des données, et l'erreur de validation croisée est tracée en fonction du nombre de composantes [1]. La règle usuelle consiste à s'arrêter au minimum de cette courbe ou juste avant, mais le choix des segments compte. Shao a montré que la validation croisée par exclusion individuelle (leave-one-out) est asymptotiquement non convergente pour sélectionner le modèle ayant la meilleure capacité prédictive, et que ce défaut est corrigé en laissant de côté des blocs d'observations plus grands [10] ; en pratique, cela plaide pour une validation croisée segmentée ou par groupes, où les mesures répétées et les échantillons d'un même lot restent dans le même segment, plutôt que pour l'exclusion de spectres isolés. Wiklund et al. proposent un test de randomisation complémentaire qui n'exige l'exclusion d'aucune donnée et qui, sur des données simulées de dimension connue et dix jeux de données réels, a bien fonctionné en combinaison avec d'autres règles de sélection [8].
Lire les diagnostics
Trois indicateurs d'erreur figurent dans tout rapport de modèle. L'erreur d'étalonnage (RMSEC) décrit l'ajustement et est toujours la plus faible ; l'erreur de validation croisée (RMSECV) estime la prédiction au sein de la population d'étalonnage ; l'erreur de prédiction sur un ensemble indépendant (RMSEP) est la seule qui teste des échantillons que le modèle n'a jamais vus, et c'est le niveau de validation de cet ensemble qui en fixe la signification [3]. L'ISO 12099 expose les statistiques de mesure des performances, dont l'erreur type de prédiction et le biais, et donne dans son annexe informative des exemples de valeurs aberrantes et de cartes de contrôle [11]. Un écart important entre RMSECV et RMSEP, ou un biais sur l'ensemble de test, signifie généralement que les échantillons de test diffèrent systématiquement de la population d'étalonnage plutôt que le modèle soit faux en soi [3].
Les diagnostics par échantillon complètent le tableau. Wold et al. passent en revue les diagnostics PLS standard — scores, loadings, résidus et distance au modèle — qui servent à repérer les échantillons éloignés des autres dans l'espace spectral ou mal ajustés [1]. Hubert et Vanden Branden montrent que, l'algorithme SIMPLS courant reposant sur la matrice de covariance croisée empirique et sur les moindres carrés ordinaires, ses résultats sont affectés par les observations anormales ; ils introduisent des variantes robustes avec des valeurs robustes de RMSECV et de RMSEP, ainsi que des graphiques de diagnostic qui visualisent et classent les valeurs aberrantes [12]. Quel que soit l'outil, un échantillon ne doit être retiré de l'étalonnage que pour un motif documenté : une valeur de référence erronée, le spectre d'un autre matériau ou un défaut de mesure. Trois habitudes gardent les diagnostics honnêtes :
- Arrêtez d'abord le plan de validation. Fixez le partage et les segments de validation croisée avant tout balayage de prétraitements ou de composantes, et appliquez le même plan à chaque candidat pour que la comparaison soit équitable [3].
- Rapportez RMSECV et RMSEP avec leur niveau de validation. Une erreur estimée sur des spectres répétés des mêmes échantillons n'est pas comparable à une erreur estimée sur un lot de production ultérieur [3].
- Traitez le retrait des valeurs aberrantes comme une décision de modélisation. Consignez quels échantillons ont été retirés et pourquoi ; une alerte de résidu ou de levier invite à enquêter, elle n'autorise pas à supprimer [1][12].
Maintenir le modèle en vie
Un étalonnage est validé pour la population et l'état d'instrument sur lesquels il a été construit. L'ASTM E1655 expose des pratiques de collecte et de traitement des données pour les étalonnages infrarouges, décrit des techniques d'étalonnage et des critères de validation des performances du modèle, suppose que l'analyseur fonctionne dans les conditions spécifiées par le fabricant aux moments de l'étalonnage et de la validation, et fournit un questionnaire à l'aune duquel un étalonnage multivarié peut être examiné [13]. L'ISO 12099 ajoute le volet opérationnel : vérification de la stabilité de l'instrument et contrôle continu des performances de l'étalonnage, avec les cartes de contrôle comme outil de surveillance [11]. Westad et Marini soulignent que la robustesse d'un modèle pour prédire des échantillons futurs importe davantage que n'importe quel indicateur de performance isolé [3] ; concrètement, cela signifie une routine de contrôles de référence sur des échantillons de production, des cartes de contrôle du biais et de l'erreur de prédiction, et une mise à jour planifiée de l'ensemble d'étalonnage lorsque apparaissent de nouvelles matières premières, saisons ou conditions de procédé.
Le déroulement dans caliX
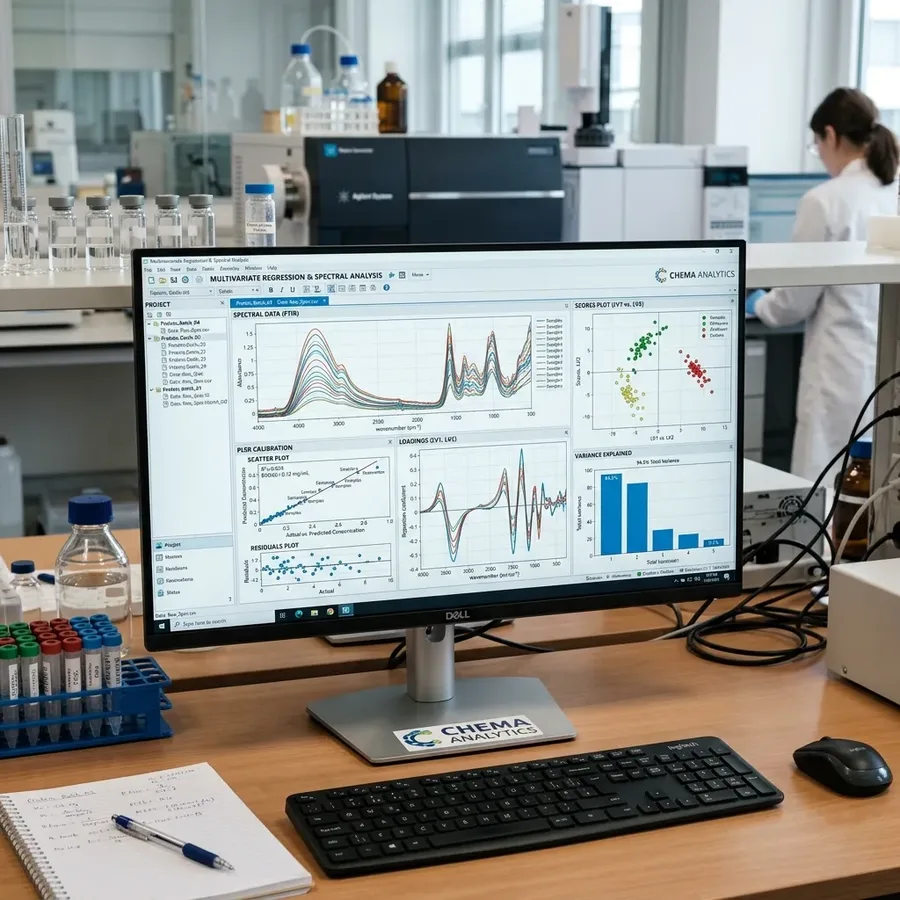
La suite caliX organise les étapes ci-dessus en un flux de travail à huit modules pour les spectres NIR, FTIR et Raman. Le module Données importe les spectres et les valeurs de référence depuis des fichiers Excel ou CSV et facilite le nettoyage des données à l'aide des indicateurs de levier PCA et PLS ; l'étape de prétraitement propose SNV, MSC, suppression de tendance, autoscaling et dérivées de Savitzky-Golay [7] ; les modules de régression manuelle et automatique construisent des modèles PLS, PLS robuste, PCR et régularisés, le nombre maximal de variables latentes et le nombre de plis de validation croisée étant fixés par l'utilisateur, tandis que le mode automatique balaie les combinaisons de chaînes de traitement et repère le point de coude de la courbe de validation [1][10]. Les diagnostics de valeurs aberrantes comprennent le T² de Hotelling et les résidus Q, le levier PLS et la distance de Mahalanobis [12] ; un module Prédiction applique le modèle finalisé aux échantillons inconnus, et les modules Transfert de données et Convertisseur de modèle assurent la standardisation entre instruments et l'export du modèle en vue de son déploiement via ProChem. Le partage, le prétraitement et le nombre de composantes adaptés à un produit donné s'établissent lors d'une étude de faisabilité avec vos propres échantillons et analyses de référence.
Références
- [1] Wold, S., Sjöström, M., Eriksson, L. (2001). PLS-regression: a basic tool of chemometrics. Chemometrics and Intelligent Laboratory Systems, 58(2), 109–130. doi:10.1016/S0169-7439(01)00155-1
- [2] Geladi, P., Kowalski, B.R. (1986). Partial least-squares regression: a tutorial. Analytica Chimica Acta, 185, 1–17. doi:10.1016/0003-2670(86)80028-9
- [3] Westad, F., Marini, F. (2015). Validation of chemometric models – A tutorial. Analytica Chimica Acta, 893, 14–24. doi:10.1016/j.aca.2015.06.056
- [4] Snee, R.D. (1977). Validation of Regression Models: Methods and Examples. Technometrics, 19(4), 415–428. doi:10.1080/00401706.1977.10489581
- [5] Kennard, R.W., Stone, L.A. (1969). Computer Aided Design of Experiments. Technometrics, 11(1), 137–148. doi:10.1080/00401706.1969.10490666
- [6] Martens, H.A., Dardenne, P. (1998). Validation and verification of regression in small data sets. Chemometrics and Intelligent Laboratory Systems, 44(1–2), 99–121. doi:10.1016/S0169-7439(98)00167-1
- [7] Rinnan, Å., van den Berg, F., Engelsen, S.B. (2009). Review of the most common pre-processing techniques for near-infrared spectra. TrAC Trends in Analytical Chemistry, 28(10), 1201–1222. doi:10.1016/j.trac.2009.07.007
- [8] Wiklund, S., Nilsson, D., Eriksson, L., Sjöström, M., Wold, S., Faber, K. (2007). A randomization test for PLS component selection. Journal of Chemometrics, 21(10–11), 427–439. doi:10.1002/cem.1086
- [9] Stone, M. (1974). Cross-Validatory Choice and Assessment of Statistical Predictions. Journal of the Royal Statistical Society: Series B (Methodological), 36(2), 111–133. doi:10.1111/j.2517-6161.1974.tb00994.x
- [10] Shao, J. (1993). Linear Model Selection by Cross-Validation. Journal of the American Statistical Association, 88(422), 486–494. doi:10.1080/01621459.1993.10476299
- [11] ISO 12099:2017. Animal feeding stuffs, cereals and milled cereal products — Guidelines for the application of near infrared spectrometry. ISO, Geneva. iso.org/standard/67352.html
- [12] Hubert, M., Vanden Branden, K. (2003). Robust methods for partial least squares regression. Journal of Chemometrics, 17(10), 537–549. doi:10.1002/cem.822
- [13] ASTM E1655-17(2024). Standard Practices for Infrared Multivariate Quantitative Analysis. ASTM International, West Conshohocken, PA. astm.org/e1655-17r24.html