Pourquoi un spectre a besoin d'un étalonnage
Un spectromètre proche infrarouge enregistre l'absorbance à de nombreuses longueurs d'onde, mais aucune longueur d'onde n'est spécifique à elle seule de la protéine, de la matière grasse ou de l'humidité : les mesures ne sont pas sélectives, et l'information relative à un constituant est répartie sur de nombreux canaux. L'étalonnage multivarié est la famille de méthodes qui extrait une information quantitative de ces données non sélectives en combinant de nombreux canaux à la fois, ce qui permet aussi de signaler les échantillons inhabituels comme aberrants [1]. L'ASTM E1655 établit des pratiques pour l'étalonnage multivarié des spectromètres infrarouges dans le proche infrarouge (environ 780 à 2500 nm) comme dans le moyen infrarouge, y compris des critères de validation des performances d'un étalonnage [2]. Ce guide explique, sans équations, comment fonctionne la régression des moindres carrés partiels (PLS) — la méthode au cœur des ouvrages de référence sur l'étalonnage [1][3] — dans des applications comme celles de l'industrie agroalimentaire et de l'alimentation animale, et comment ses performances sont jugées.
Ce que fait la PLS : les variables latentes
L'approche la plus évidente, une régression linéaire multiple ordinaire sur toutes les longueurs d'onde, échoue parce que les spectres contiennent bien plus de variables qu'il n'y a d'échantillons d'étalonnage et que les longueurs d'onde voisines sont fortement corrélées entre elles. Le tutoriel de Geladi et Kowalski expose ces insuffisances des méthodes de régression classiques et présente la PLS comme un moyen de les contourner [4]. Wold et al. décrivent la régression PLS comme un modèle linéaire qui relie la matrice spectrale X aux valeurs de référence Y tout en modélisant la structure interne de X, et attribuent son utilité à sa capacité à traiter de nombreuses variables bruitées, colinéaires, voire incomplètes [5].
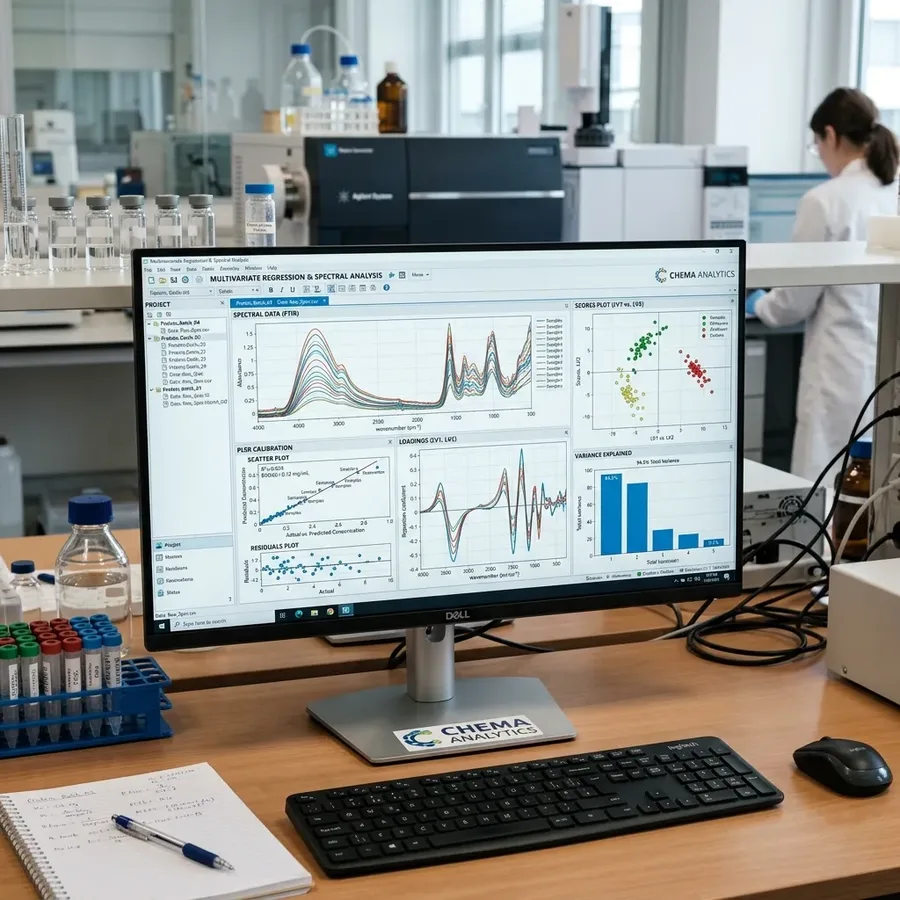
En pratique, la PLS comprime chaque spectre en un petit nombre de scores sur des variables latentes, également appelées facteurs ou composantes. Chaque variable latente est une combinaison pondérée de toutes les longueurs d'onde, choisie pour décrire une variation spectrale systématique qui est aussi liée à la valeur de référence ; la composition est ensuite prédite à partir de ces quelques scores plutôt qu'à partir de centaines d'absorbances brutes [4][5]. Haaland et Thomas ont montré comment la PLS se rattache aux moindres carrés classiques, aux moindres carrés inverses et à la régression sur composantes principales, et que des informations spectrales chimiquement interprétables peuvent être lues dans les étapes intermédiaires de l'algorithme, plus directement qu'avec la régression sur composantes principales [6].
Combien de facteurs ?
Chaque facteur supplémentaire ajuste plus étroitement le modèle à ses propres échantillons d'étalonnage, mais au-delà d'un certain point, les facteurs supplémentaires décrivent du bruit et des particularités propres aux échantillons plutôt que de la chimie. Gowen et al. en résument la conséquence : trop peu de variables latentes conduisent à un sous-ajustement et trop à un surajustement, les deux entraînant de mauvaises performances sur les échantillons futurs ; un signe reconnu de surajustement est un vecteur de régression bruité présentant des pics aigus et oscillants [7]. Le nombre de facteurs est donc choisi d'après l'erreur de prédiction sur des échantillons non utilisés pour ajuster le modèle, par validation croisée ou à l'aide d'un jeu de test distinct, en examinant aussi les coefficients de régression [1][7]. Haaland et Thomas décrivaient déjà des procédures de sélection du nombre optimal de facteurs afin de limiter le surajustement des données d'étalonnage [6].
Étalonnage, validation et statistiques d'erreur
Trois erreurs quadratiques moyennes sont couramment rapportées [3]. Le RMSEC est l'erreur sur les échantillons d'étalonnage eux-mêmes et il est toujours optimiste. Le RMSECV provient de la validation croisée, dans laquelle chaque échantillon (ou segment d'échantillons) est prédit par un modèle construit sans lui. Le RMSEP est l'erreur sur un jeu de validation indépendant d'échantillons qui n'ont joué aucun rôle dans la construction du modèle, et constitue la meilleure estimation des performances en utilisation de routine. L'ISO 12099, ligne directrice pour l'analyse NIR des aliments pour animaux et des céréales, comporte des articles distincts sur l'étalonnage et la validation initiale ainsi que sur les statistiques de mesure des performances, dont le biais, l'erreur standard de prédiction (SEP) et la pente [8]. Westad et Marini avertissent que la division aléatoire d'un même jeu de données en parties d'étalonnage et de test ne se justifie qu'en l'absence de structure systématique dans les échantillons ; lorsque la validation couvre la variation de répétabilité, de reproductibilité, d'instrument et de matière première, les valeurs d'erreur comme le nombre de facteurs peuvent changer [9]. Trois conséquences pratiques :
- Valider sur des échantillons réellement nouveaux. Les échantillons de test doivent provenir de lots, de saisons ou de fournisseurs différents de ceux du jeu d'étalonnage, afin que la validation reflète la variation que l'analyseur rencontrera en service [9].
- Rester dans le domaine étalonné. La procédure d'étalonnage définit le domaine dans lequel les prédictions sont valides ; les échantillons situés hors de ce domaine, ou signalés comme spectres aberrants, ne doivent pas être rapportés comme des résultats normaux [1][2].
- Ne pas juger un modèle sur un seul indice. Les rapports synthétiques tels que le RPD (écart-type des valeurs de référence divisé par l'erreur de prédiction) sont largement utilisés, mais Esbensen et al. critiquent le fait de s'y fier aveuglément comme à une mesure universelle de la qualité d'un étalonnage [10].
La méthode de référence fixe le plancher
Un étalonnage est construit et testé à partir de valeurs issues d'une méthode de référence de laboratoire, et ces valeurs comportent leur propre erreur. Faber et Kowalski soulignent que l'erreur de prédiction estimée par rapport aux valeurs de référence mesurées est une erreur apparente, systématiquement supérieure à l'erreur de prédiction réelle, car l'erreur aléatoire de la mesure de référence ne peut être prédite par aucun modèle et est comptée à tort comme une insuffisance de l'étalonnage [11]. La relation est plus subtile que “ le NIR ne peut jamais être meilleur que la référence ” : DiFoggio range cette affirmation parmi les idées fausses récurrentes sur l'analyse NIR et donne des contre-exemples [12]. Concrètement, cela signifie qu'un RMSEP rapporté ne peut pas, de manière convaincante, descendre sous la répétabilité du laboratoire de référence ; connaître cette répétabilité fait donc partie de l'interprétation de tout résultat de validation [11][12].
L'approche d'USTECH en matière d'étalonnage
Les modèles PLS des analyseurs USTECH tels que le ProLine2550 et le MasterLine17EC sont développés dans le logiciel de chimiométrie caliX et déployés sur le procédé via ProChem. Le prétraitement spectral est traité dans les guides consacrés à MSC et SNV et au filtrage de Savitzky-Golay, et le flux de travail logiciel dans la régression PLS dans caliX. La validation suit les principes ci-dessus, avec des échantillons indépendants et les statistiques définies dans l'ISO 12099 et l'ASTM E1655 [2][8]. La capacité d'un paramètre à atteindre l'exactitude requise par un procédé est établie lors d'une étude de faisabilité réalisée avec vos propres échantillons et analyses de référence.
Références
- [1] Martens, H., Næs, T. (1989). Multivariate Calibration. John Wiley & Sons, Chichester (paperback edition 1992, ISBN 978-0-471-93047-1). wiley.com
- [2] ASTM E1655-17(2024). Standard Practices for Infrared Multivariate Quantitative Analysis. ASTM International, West Conshohocken, PA. store.astm.org/e1655-17r24.html
- [3] Næs, T., Isaksson, T., Fearn, T., Davies, T. (2017). A User-Friendly Guide to Multivariate Calibration and Classification, 2nd edition. IM Publications Open, Chichester. doi:10.1255/978-1-906715-25-0
- [4] Geladi, P., Kowalski, B.R. (1986). Partial least-squares regression: a tutorial. Analytica Chimica Acta, 185, 1–17. doi:10.1016/0003-2670(86)80028-9
- [5] Wold, S., Sjöström, M., Eriksson, L. (2001). PLS-regression: a basic tool of chemometrics. Chemometrics and Intelligent Laboratory Systems, 58(2), 109–130. doi:10.1016/S0169-7439(01)00155-1
- [6] Haaland, D.M., Thomas, E.V. (1988). Partial least-squares methods for spectral analyses. 1. Relation to other quantitative calibration methods and the extraction of qualitative information. Analytical Chemistry, 60(11), 1193–1202. doi:10.1021/ac00162a020
- [7] Gowen, A.A., Downey, G., Esquerre, C., O’Donnell, C.P. (2011). Preventing over-fitting in PLS calibration models of near-infrared (NIR) spectroscopy data using regression coefficients. Journal of Chemometrics, 25(7), 375–381. doi:10.1002/cem.1349
- [8] ISO 12099:2017. Animal feeding stuffs, cereals and milled cereal products — Guidelines for the application of near infrared spectrometry. ISO, Geneva. iso.org/standard/67352.html
- [9] Westad, F., Marini, F. (2015). Validation of chemometric models – A tutorial. Analytica Chimica Acta, 893, 14–24. doi:10.1016/j.aca.2015.06.056
- [10] Esbensen, K.H., Geladi, P., Larsen, A. (2014). The RPD myth… NIR news, 25(5), 24–28. doi:10.1255/nirn.1462
- [11] Faber, K., Kowalski, B.R. (1997). Improved prediction error estimates for multivariate calibration by correcting for the measurement error in the reference values. Applied Spectroscopy, 51(5), 660–665. doi:10.1366/0003702971941061
- [12] DiFoggio, R. (1995). Examination of some misconceptions about near-infrared analysis. Applied Spectroscopy, 49(1), 67–75. doi:10.1366/0003702953963247